Day One Ready
几分钟内即可搭建面向生产环境的AI推理平台,开箱即具备模型服务、调度、弹性伸缩、可观测性和运维等核心能力。提供直观的统一WebUI面板,无需复杂的底层调优即可轻松接管集群。
自动弹性伸缩 (Auto-Scaling)ENABLED: 4-32 Pods
基于服务质量的动态限流算法TTFT < 10s, OPTS > 20
让大模型推理从“能跑”到“生产好用”,让每张 GPU 化身高效 Token 产线。
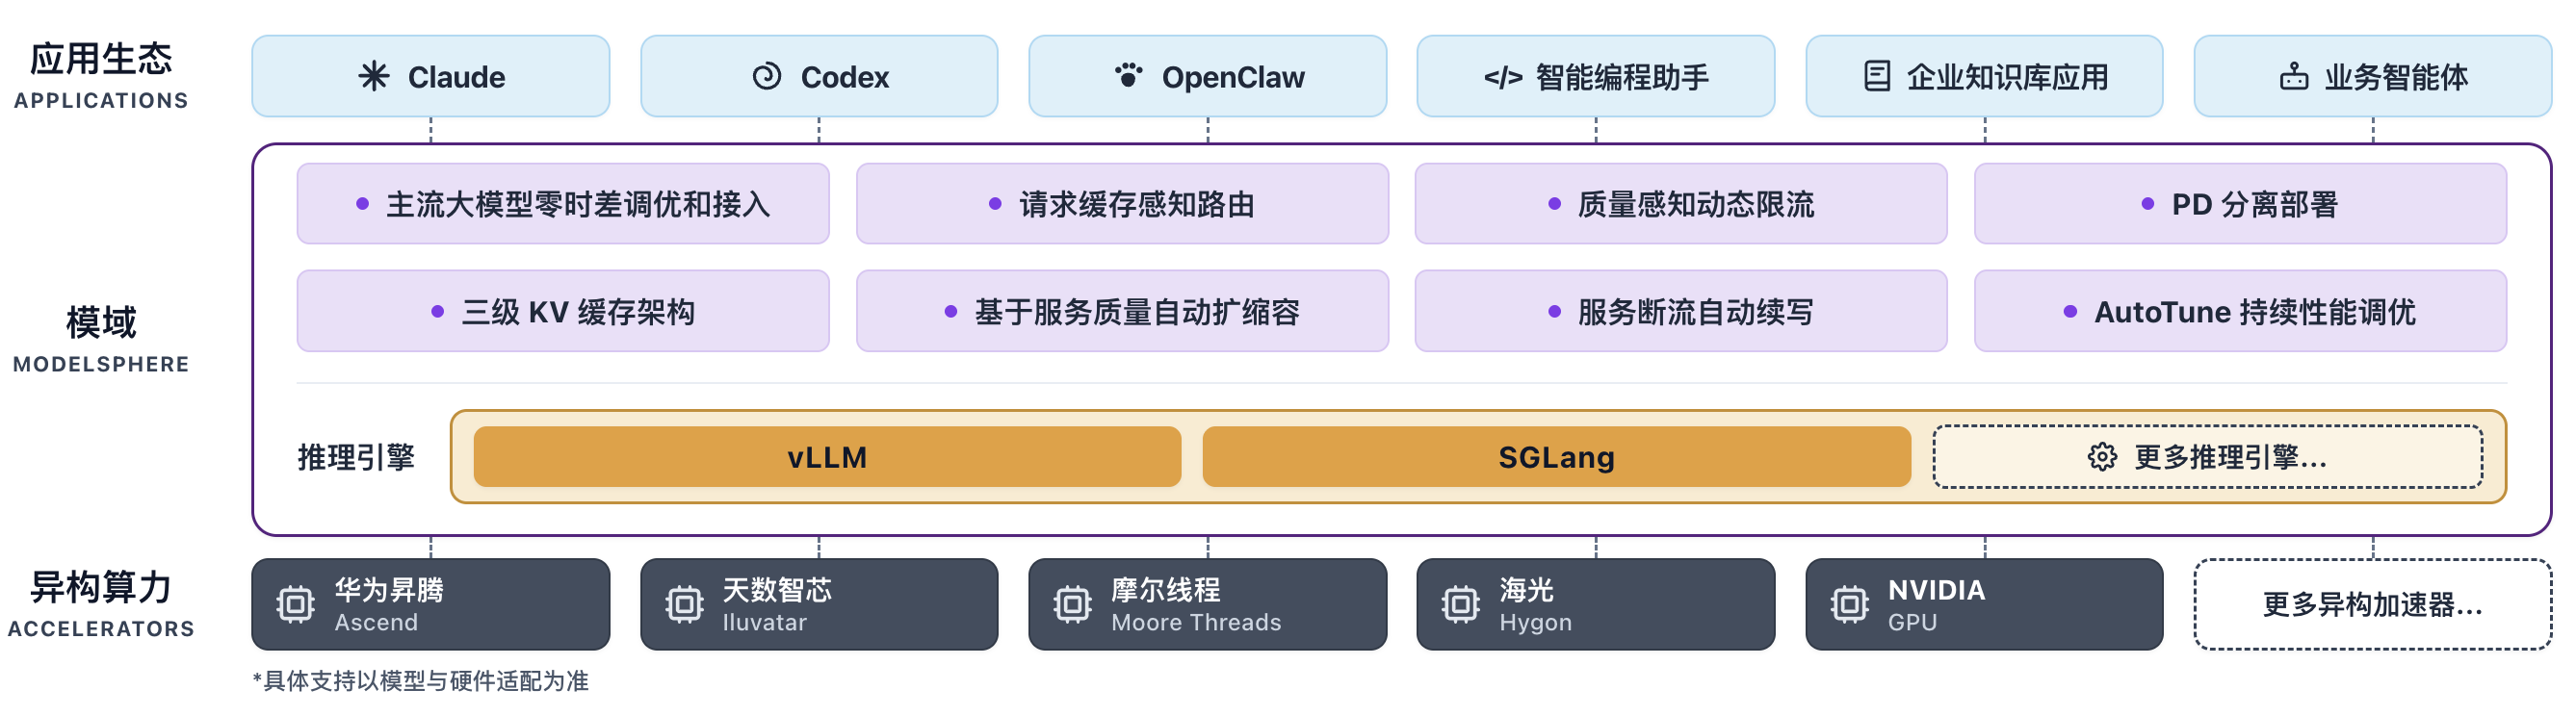
基于 Kubernetes 构建,将模型部署、缓存感知路由、按 SLO 弹性伸缩、全维可观测性、挂起故障秒级自愈与 AutoTune 闭环组织成一套工业级推理调度系统,帮助开发者在复杂异构算力上稳定承载大规模生产流量。
标准化 API 接入,支持各类 Agent 框架。
工业级路由调度、SLO 弹缩、零感知断流自愈与推理引擎编排。
统一拓扑算力纳管,消除芯片生态壁垒与厂商绑定。
Architectural Pillars
为生产级严肃工程而生。模域将前沿学术成果与大规模线上运维沉淀收敛为标准化的平台体系。
几分钟内即可搭建面向生产环境的AI推理平台,开箱即具备模型服务、调度、弹性伸缩、可观测性和运维等核心能力。提供直观的统一WebUI面板,无需复杂的底层调优即可轻松接管集群。
通过统一的平台无缝运行在多种异构AI硬件之上。原生兼容通用GPU,并深度基于EngineX适配华为昇腾、天数智芯、摩尔线程、海光等加速芯片,实现混合节点的统一纳管。
紧跟快速演进的模型生态,通过我们的推理性能优化社区,第一时间完成新模型适配和调优,让最新大模型能够快速导入、配置并部署到生产环境。
持续集成最新的推理优化能力,通过内置AutoTune根据模型、硬件和真实业务负载自动调优,在延迟、吞吐和资源效率之间持续获得更优表现。
客户端保持 SSE 长连接;网关将请求分流至 模型服务 A;服务依次生成并吐出 Token 1 → 2 → 3 → 4 → 5。
模型服务 A 遭遇 GPU 显存死锁或 CUDA Illegal Memory Access,生成中断。Hang-Watcher 探针在 140ms 内检测到 Token Emit 超时,通知网关切断与 A 的通道。
聚合调度网关截取已吐出的 Token 1~5,结合 L3 KV Cache 共享句柄,瞬间重定向发送至健康备用节点 模型服务 B。
模型服务 B 极速计算并接续生成 Token 6 → 7 → 8... 网关直接追加注入原 SSE 流,客户端用户界面毫无感知,零丢字体验。
告别单一粗暴的 TPM/RPM 静态限流,建立基于首字延迟 (TTFT) 与每秒产出 (OTPS) 的生产级实时反馈调控。
静态限流无法感知 Prefill 算力饱和引发的排队雪崩。ModelSphere 动态监测首字延迟。当 TTFT 突破阈值时,网关在毫秒级返回携带 Retry-After: 120ms 的智能 429 退避,避免集群被拖死。
随并发需求毫秒级调整推理 Pod 副本;非高峰期高优模型借用闲置芯片,使集群整体 GPU 利用率从行业平均 45% 大幅跃升至 85% 以上,且缩容时保证就绪请求排空再释放。
告别繁冗的人工基准盲测。ModelSphere 将线上真实请求、低谷空闲算力、网格化超参搜索与零停机灰度上线串联成全自动化演进飞轮。
用空闲算力持续榨干硬件潜能,让 LLM 推理服务越用越快。
静态数据集测试 → 7 天滑动窗口真实流量特征蓄水
占用生产资源压测 → 夜间低峰期闲置算力并发网格搜索
停机重启更新参数 → 冠军方案自动验证,生产环境零停机热加载
稳定运行,持续提供高质量低时延高可用服务
最优配置自动部署,零丢流热加载
构建滑动窗口数据集与前缀拓扑
基于真实负载比选出冠军推理方案
夜间低峰期并发搜索更优推理超参
公开完整的基准输入输出分布、硬件拓扑与权衡代价,每一次调优收益皆可复核。
| 模型与架构 | 硬件环境 | 负载场景 (Prompt+Output) | 吞吐对比 (Default vs Tuned) | 性能飞跃 | 调优技术与代价说明 |
|---|---|---|---|---|---|
| MiMo-V2.5 | 8 × NVIDIA H100 | 50k + 1.5k (长上下文) | 13,900 → 30,600 tok/s | +119.9% | 并发 4→26; TTFT 4.81s→7.66s (符合 SLO ≤ 8s); GPQA 精度微降 3.03% (显式折中) |
| DeepSeek-V4.1-Flash | 8 × NVIDIA H100 | 50k + 1.5k / 8k + 1k | 长文大幅跃升 / 常用平稳 | +89.5% / +5.0% | 客观体现“负载改变收益改变”,AutoTune 针对超长上下文自适应调整 Chunk 分块 |
| Qwen3.6-35B-A3B | 2 × NVIDIA H800 | Agentic (c=8 并发多轮) | 6,200 → 8,016 tok/s | +29.3% | SGLang + FlashAttention-3 + FP8 + Chunked Prefill 32768 + extra_buffer 深度融合 |
| GLM-5.3 (NVFP4) | 4 × NVIDIA B300 | 全量生产仿真混合集 | 基线对比 → 最高峰值 | +195.3% | AutoTune 搜索至最优 TP4 单节点拓扑,集成 modelopt_fp4 极致内核 |